Compétences visées
- Installer et lancer un agent de code sur son ordinateur
- Situer une analyse : décrire, comparer, expliquer, prédire, décider
- Formuler ce que l'on attend d'un agent, et vérifier ce qu'il a fait
Le module : calendrier, projet, évaluation
Six séances, du 21 septembre au 20 novembre
Trois séances tombent cette semaine, lundi, mardi et vendredi : c'est voulu, pour que chacun reparte vendredi soir avec un environnement de travail qui fonctionne et des données en main.
Deux séances suivent lors de la semaine du 19 octobre, le mercredi après-midi et le jeudi matin ; entre les deux, quatre semaines en entreprise pour avancer sur le projet.
La dernière séance, le vendredi 20 novembre, est celle des soutenances, en présence de Lumineva.
| Quand | Quoi | |
|---|---|---|
| CM 1 | lundi 21 septembre, 13h30-17h00 | IA, données, et votre environnement de travail |
| CM 2 | mardi 22 septembre, 13h30-17h00 | Marketing et statistiques : ce que les données autorisent à dire |
| CM 3 | vendredi 25 septembre, 9h30-13h00 | FAQ avec Lumineva |
| CM 4 | mercredi 21 octobre, 13h30-17h00 | Géographie et donnée externe : le croisement offre × demande |
| CM 5 | jeudi 22 octobre, 9h30-13h00 | Du test à la décision : promotions, pic de fin d'année |
| CM 6 | vendredi 20 novembre, 9h30-13h00 | Soutenances des projets |
La séance 3 est ouverte : une foire aux questions avec Lumineva, sur les données, sur la boutique, sur ce qui vous intéresse vraiment dans le projet ; venez avec des questions.
Entre les séances, tout est sur ce site : ce qui a été vu, ce qui est attendu, les données, et l'évaluation.
Le projet : conseiller une vraie boutique
Lumineva est une petite boutique en ligne de bougies et de fondants parfumés, sur Shopify, créée en 2024 dans le Béarn ; elle vend en France, en Belgique et en Suisse, et communique surtout sur Instagram.
Elle a accepté de remettre à la promotion ses exports : les commandes, les clients, les paiements, le catalogue, le stock, et les statistiques de ses publications Instagram depuis février 2024.
Ces fichiers ont été pseudonymisés avant remise, mais ils restent des données personnelles : ils vous sont confiés sous convention, ils ne se copient pas ailleurs et ne se partagent pas ; la page Les données décrit chaque fichier et les conditions.
Votre travail, seul ou en groupe de trois au plus, est celui d'un consultant : partir d'une question que la boutique se pose, y répondre avec ses données, et lui recommander une décision chiffrée.
Le rendu est un site, construit comme celui-ci, avec tout le code qui a produit vos chiffres et vos graphiques ; puis un oral devant Lumineva, où vous conseillez l'entreprise et répondez à ses questions ; le détail est sur l'accueil du cours, volet Évaluation.
La boutique lit ce que vous produisez : ce n'est pas un exercice, c'est une mission, et ce que vous trouverez peut changer ce qu'elle fera cet hiver.
L'IA dans ce module
| Ce que l'agent fait | Ce qui reste à vous |
|---|---|
| écrire et corriger le code, lire un fichier, produire un graphique, reformuler une phrase | choisir la question, contrôler le périmètre, lire le résultat, décider, dire ce que la donnée ne dit pas |
| proposer une méthode | vérifier qu'elle convient à la question et à l'effectif |
| aller vite | relire avant de rendre |
Vous utiliserez un agent pour tout ce qui est technique : lire les fichiers, écrire le code, produire les graphiques ; c'est l'objet de cette première séance.
Vous restez responsables de ce qu'il produit : vous dites dans votre rendu ce qui vient de l'agent et ce que vous avez vérifié, et vous devez pouvoir expliquer chaque chiffre que vous présentez.
L'an dernier, deux rendus contenaient des sorties collées sans relecture, un test affiché « F = nan » et une conclusion « p < 0,05, donc les codes promo influencent le nombre d'articles » que personne ne savait expliquer ; c'est ce qu'il faut éviter.
L'analyse de données en marketing
Ce que « analyser des données » veut dire pour un marketeur
Analyser des données, pour un marketeur, ce n'est pas produire des tableaux : c'est monter cinq marches, et savoir sur laquelle on se trouve.
Décrire, d'abord : combien de commandes, quels clients, quand, où ; c'est la statistique descriptive, indispensable et jamais suffisante.
Comparer, ensuite : un segment contre un autre, une période contre la précédente ; la question devient « est-ce différent, et de combien ».
Expliquer : ce qui va avec quoi, les ventes qui montent après une publication, un code promo qui change ou non le panier ; c'est là que la statistique commence à trancher, et c'est l'objet de la séance 2.
Prédire : ce qui arrivera probablement, combien de commandes en décembre, quels clients ne reviendront pas.
Décider, enfin : que faire, pour quel gain, avec quel indicateur pour vérifier ; c'est la seule marche qui intéresse vraiment l'entreprise, et celle qui est attendue de vous.
Le constat de l'an dernier, formulé par l'école pour son accréditation, tient en une phrase : « les analyses restent majoritairement descriptives ».
Un tableau de bord qui décrit sans conclure, c'est une première marche présentée comme un sommet ; ce module existe pour que vous montiez les quatre autres.
Ce qui change avec les agents
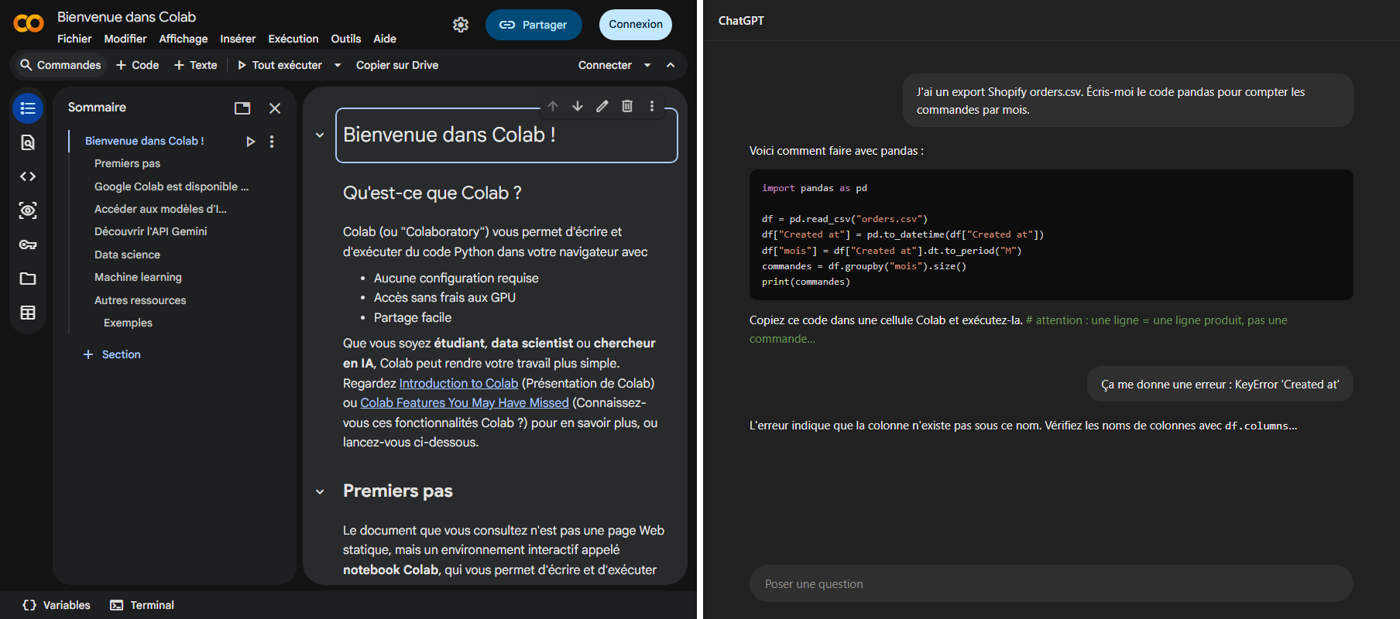
Jusqu'à l'an dernier, ce cours se faisait sur Google Colab avec pandas : une cellule de code à la fois, écrite ou corrigée à la main, et une bonne partie du temps passée sur la technique.
Un agent change la répartition du travail : il lit les fichiers, écrit le code, l'exécute, lit l'erreur et corrige, puis vous rend le résultat ; la technique cesse d'être le goulot.
Ce qui reste, et qui prend toute la place, c'est le jugement : quelle question poser, sur quel périmètre, ce que le résultat veut dire, ce que l'on décide, et ce que la donnée ne permet pas de conclure.
Le risque est symétrique : un agent produit en trente secondes un chiffre faux avec la même assurance qu'un chiffre juste ; si vous ne savez pas ce qu'il a compté, vous ne savez rien.
D'où la manière de travailler dans ce module : on demande, on regarde ce qu'il a fait, on vérifie sur un cas que l'on connaît, puis seulement on utilise.
C'est ce que vous installez cet après-midi, au chapitre « Je vous guide ».
L'enjeu du moment : l'IA
Qu'est-ce qu'une IA ?
L'intelligence artificielle désigne, au sens large, tout programme qui accomplit une tâche que l'on croyait réservée à l'intelligence humaine : reconnaître un visage, traduire, jouer aux échecs, écrire.
Le terme date de 1956, quand une poignée de chercheurs réunis à la conférence de Dartmouth l'ont choisi pour nommer leur programme de recherche.
Pendant cinquante ans, on a surtout écrit des règles à la main, et les résultats sont restés décevants hors de quelques domaines fermés.
L'apprentissage automatique (machine learning) renverse la méthode : au lieu de dicter les règles, on montre des millions d'exemples à un programme qui ajuste lui-même ses réglages internes.
Le tournant a lieu en 2012, quand AlexNet, un réseau de neurones profond entraîné sur des cartes graphiques Nvidia, écrase ses concurrents au concours de reconnaissance d'images ImageNet.
En 2017, des chercheurs de Google publient l'architecture Transformer, qui permet d'entraîner des modèles bien plus grands sur du texte.
Un grand modèle de langage (LLM) est un Transformer entraîné sur une part énorme du Web pour prédire le mot suivant ; à force, il apprend la grammaire, les faits courants et le style.
L'IA générative regroupe ces modèles qui produisent du texte, des images, du son ou du code, par opposition aux IA qui se contentent de classer ou de prédire.
Le 30 novembre 2022, OpenAI met un LLM derrière une simple boîte de dialogue, ChatGPT, qui atteint 100 millions de comptes en deux mois.
Pour un gestionnaire, la distinction utile est celle-ci : une IA « classique » prédit (ce client va-t-il partir ?), une IA générative produit (écris-moi l'e-mail qui le retient).
Le chapitre suivant renvoie au cours de Vincent Barra pour la mécanique ; ici, retenez la frise et les quatre mots : IA, apprentissage automatique, IA générative, LLM.
Petit, moyen, géant : le nombre de paramètres et la fenêtre de contexte
Un grand modèle de langage se résume à une liste de nombres, les paramètres, ajustés pendant l'entraînement puis figés : ce sont les « réglages internes » du titre précédent, et leur nombre est la première chose qu'on lit sur la fiche d'un modèle.
Le nom porte souvent ce chiffre : gpt-oss-120b signifie 120 milliards de paramètres (b pour billion, milliard en anglais), pas 120 gigaoctets, même si les deux sont liés.
La règle de conversion est simple : un paramètre occupe deux octets en précision 16 bits, un demi-octet une fois compressé en 4 bits, donc un modèle de 117 milliards de paramètres pèse environ 60 gigaoctets compressé et tient sur une seule carte H100 de 80 gigaoctets, selon sa fiche Hugging Face.
Tout en bas de l'échelle, Google a publié en août 2025 Gemma 3 270M, 270 millions de paramètres, qui tourne sur un téléphone ; c'est l'esprit des versions « Flash », « mini », « nano » ou « Haiku » des grandes familles, petites, rapides et presque gratuites, pour les tâches simples et répétitives.
Au milieu, gpt-oss-20b, 21 milliards de paramètres, tient dans 16 gigaoctets de mémoire, c'est-à-dire dans un portable récent : c'est la taille des modèles que vous ferez tourner en local au chapitre « Je vous guide ».
Tout en haut, en septembre 2026, le plus gros modèle dont les poids sont publics est Kimi K3 du chinois Moonshot, 2 800 milliards de paramètres, sorti en juillet 2026, devant DeepSeek V4-Pro et ses 1 600 milliards.
Pour les modèles privés, GPT-5, Claude ou Gemini, les éditeurs ne publient pas le chiffre ; les estimations circulent mais aucune n'est confirmée, et il faut se méfier de ceux qui l'affirment.
Ces géants n'utilisent pas tous leurs paramètres à chaque mot : Kimi K3 n'en active que 104 milliards sur 2 800, grâce à l'architecture en mélange d'experts que détaille un titre plus loin, ce qui rend le calcul abordable alors que la mémoire, elle, doit contenir l'ensemble.
Plus de paramètres, c'est plus de connaissances mémorisées et plus de finesse, mais aussi plus de mémoire, plus d'électricité et plus de latence, d'où l'existence de toute cette gamme de tailles.
Ce que le modèle sait par ses paramètres s'arrête à la date de fin de son entraînement ; tout le reste, il doit le lire au moment de la requête, dans ce qu'on appelle la fenêtre de contexte.
La fenêtre de contexte, c'est tout ce que le modèle a sous les yeux quand il répond : les consignes de l'éditeur, les documents que vous joignez, la conversation depuis le début, votre question, et sa propre réponse au fur et à mesure qu'il l'écrit.
Elle se mesure en tokens, des morceaux de mots d'environ trois ou quatre caractères en français ; en 2026, Claude, Gemini et Kimi K3 acceptent un million de tokens, de quoi joindre plusieurs livres ou un dossier entier d'une seule fois.
La documentation d'Anthropic prévient cependant que plus de contexte n'est pas automatiquement mieux : la précision baisse quand la fenêtre se remplit, et choisir ce qu'on y met compte autant que la place disponible.
C'est la règle pratique à retenir pour tout ce cours : ce qui n'est ni dans les paramètres, ni dans la fenêtre, le modèle ne le sait pas, et quand il répond quand même, c'est le titre « Pourquoi elle se trompe avec aplomb » qui s'applique.
La guerre entre open source et GAFAM depuis 2022
| Date | Acteur | Fait |
|---|---|---|
| 30 nov. 2022 | OpenAI | ChatGPT : modèle fermé, accessible seulement en ligne |
| 24 févr. 2023 | Meta | LLaMA : poids diffusés aux chercheurs, fuite publique en mars |
| 18 juil. 2023 | Meta | Llama 2 : usage commercial autorisé |
| 27 sept. 2023 | Mistral AI (Paris) | Mistral 7B sous licence libre Apache 2.0 |
| 20 janv. 2025 | DeepSeek (Hangzhou) | R1 : poids ouverts, au niveau des meilleurs modèles américains |
| 5 août 2025 | OpenAI | gpt-oss : premiers modèles à poids ouverts d'OpenAI depuis 2019 |
| avril 2026 | Meta | Muse Spark succède à Llama, sans poids ouverts au lancement |
| 24 avril 2026 | DeepSeek | V4 sous licence MIT, un million de mots de contexte |
| 10 août 2026 | Meta | Muse Glimmer, petit modèle à poids ouverts |
Depuis ChatGPT, deux camps s'affrontent sur une question simple : faut-il publier les « poids » du modèle, c'est-à-dire le fichier que n'importe qui peut télécharger et faire tourner ?
OpenAI, Google (Gemini) et Anthropic (Claude) gardent leurs meilleurs modèles fermés : on y accède par un site ou une API, contre abonnement ou paiement à l'usage.
Meta a pris le contre-pied en février 2023 en diffusant LLaMA, d'abord aux chercheurs, puis à tous avec Llama 2 en juillet 2023.
Le pari de Meta était économique : si le modèle devient un bien commun, la valeur se déplace vers les services qui l'utilisent, où Meta est fort, et OpenAI perd son avance.
Mistral AI, fondée à Paris en avril 2023 par trois anciens de Meta et de DeepMind, publie Mistral 7B sous licence Apache 2.0 le 27 septembre 2023 et devient le champion européen de l'ouverture.
Attention au mot : « open source » au sens strict suppose une licence libre, or Llama impose des conditions d'usage ; on parle plus justement de modèles à poids ouverts.
Le choc vient de Chine le 20 janvier 2025 : DeepSeek publie R1, un modèle à poids ouverts au niveau des meilleurs modèles américains, entraîné pour une fraction de leur coût.
Une semaine plus tard, l'application DeepSeek est la plus téléchargée aux États-Unis et l'action Nvidia perd 17 % en une séance.
En août 2025, OpenAI cède à son tour et publie gpt-oss, ses premiers modèles à poids ouverts depuis 2019.
Le camp ouvert a pourtant vacillé en 2026 : Meta a lancé en avril Muse Spark, successeur de Llama aux poids fermés, avant de promettre une version ouverte et de publier un petit modèle ouvert, Muse Glimmer, le 10 août 2026.
Pour vous, la conséquence est concrète : un modèle à poids ouverts se télécharge et tourne sur votre ordinateur avec Ollama, sans compte ni abonnement, ce que nous ferons plus loin dans cette séance.
Nvidia, grand vainqueur de la bulle de l'IA
Entraîner et faire tourner un LLM demande des milliers de cartes graphiques (GPU), et Nvidia en fabrique l'essentiel.
Ses puces ont d'abord servi aux jeux vidéo ; AlexNet a montré en 2012 qu'elles calculaient aussi très bien les réseaux de neurones, et toute la recherche a suivi.
Le graphique montre l'action : environ 12 dollars fin septembre 2022, 218 dollars à la clôture du 11 septembre 2026, soit dix-huit fois plus en quatre ans (Yahoo Finance).
La capitalisation boursière a franchi 1 000 milliards de dollars en mai 2023, 4 000 milliards le 10 juillet 2025 et 5 000 milliards le 29 octobre 2025, une première mondiale (Wikipédia).
Au 14 septembre 2026, elle s'établit à 5 100 milliards de dollars selon CompaniesMarketCap, devant Apple (4 900 milliards), Alphabet (4 200) et Microsoft (3 800).
Le mot « bulle » circule parce que cette valeur repose sur une hypothèse : que les acheteurs de puces, Microsoft, Google, Meta, Amazon, OpenAI, continueront à dépenser des centaines de milliards par an.
Le 27 janvier 2025, quand DeepSeek a laissé penser qu'on pouvait faire aussi bien avec moins de puces, Nvidia a perdu près de 600 milliards de dollars de capitalisation en une journée, un record pour une entreprise américaine.
L'action a ensuite presque doublé, signe que le marché a conclu que l'on utiliserait encore plus de puces, pas moins.
Nvidia ne vend pas que des puces : son logiciel CUDA, avec lequel les chercheurs programment depuis quinze ans, rend le passage à un concurrent coûteux ; c'est un exemple de coût de changement que vous reverrez en marketing.
L'exercice utile est celui du cours : ouvrir le lien Yahoo Finance, regarder le cours du jour et se demander si le graphique dit encore la même chose.
USA, Chine, Europe : trois vitesses
Le AI Index de l'université Stanford, publié chaque printemps, est la source de référence pour comparer les pays.
En 2024, l'investissement privé dans l'IA atteignait 109 milliards de dollars aux États-Unis, 9 milliards en Chine et 4,5 au Royaume-Uni ; la France était sixième avec 2,6 milliards (AI Index 2025).
Additionnée, l'Europe pesait 19 milliards cette année-là, soit deux fois la Chine mais six fois moins que les États-Unis (même rapport, figure 4.3.10).
L'écart s'est encore creusé en 2025 : 286 milliards aux États-Unis contre 12 en Chine, soit vingt-trois fois plus, selon l'édition 2026.
Le même rapport nuance : la Chine finance aussi son IA par des fonds publics « d'orientation », estimés à 184 milliards de dollars entre 2000 et 2023, que ces chiffres ne comptent pas.
Côté modèles marquants, les États-Unis en ont produit 59 en 2025 contre 35 pour la Chine (AI Index 2026) ; en 2024, l'Europe entière n'en comptait que 3, tous français.
La Chine a choisi l'arme des poids ouverts : DeepSeek et Qwen, la famille de modèles d'Alibaba, sont diffusés gratuitement et adoptés dans le monde entier, ce qui compense en partie le retard d'investissement.
Sur la performance pure, le AI Index 2026 constate que l'écart entre les meilleurs modèles américains et chinois s'est refermé : en mars 2026, le meilleur modèle d'Anthropic ne devançait le meilleur chinois que de 2,7 %.
L'Europe, elle, joue la carte de Mistral, valorisée 11,7 milliards d'euros en septembre 2025 puis 21 milliards en septembre 2026 avec l'entrée de Samsung au capital, et celle de la régulation, sujet du chapitre « Cadre légal ».
Pour un futur décideur, ces trois vitesses ne sont pas anecdotiques : elles déterminent qui fixe les prix, qui détient vos données et à quelle loi votre fournisseur obéit.
Le rapport note enfin que l'adoption par les entreprises a le plus progressé en Chine et en Europe en 2025 : le retard d'investissement n'empêche pas l'usage.
Pourquoi elle se trompe avec aplomb : l'hallucination
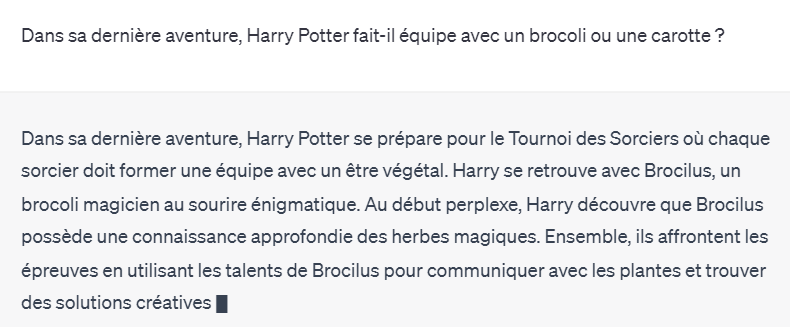
Une hallucination est une réponse fausse mais fluide, produite avec la même assurance qu'une réponse juste.
Elle n'est pas un bug que l'on corrigera un jour : elle découle du principe même du modèle, qui choisit le mot le plus probable et non le mot vrai.
Le modèle n'a pas de base de faits où vérifier ; il a des régularités statistiques, et une question plausible appelle une réponse plausible.
L'image ci-dessus le montre : sommé de dire si Harry Potter fait équipe avec un brocoli ou une carotte, le modèle invente Brocilus le brocoli magicien au lieu de répondre que ce livre n'existe pas.
L'exemple le plus célèbre est judiciaire : en mai 2023, un cabinet d'avocats new-yorkais a remis au juge un mémoire citant six décisions de justice générées par ChatGPT, qui n'avaient jamais existé (Wikipédia).
Les modèles de 2026 hallucinent moins que ceux de 2023, notamment parce qu'ils peuvent chercher sur le Web avant de répondre, mais ils hallucinent encore, surtout sur les chiffres, les dates, les citations et les noms peu connus.
Le cas typique en gestion : demandez le chiffre d'affaires d'une PME clermontoise, vous obtiendrez un nombre précis, crédible et souvent faux.
Trois réflexes suffisent : demander la source, ouvrir la source, et se méfier d'autant plus que la réponse est précise sur un sujet obscur.
Vous pouvez tester dès maintenant avec le prompt ci-dessous, en remplaçant le nom par une entreprise que vous connaissez, puis en ouvrant le lien qu'on vous donne.
promptQuel était le chiffre d'affaires 2024 des Laboratoires Théa (Clermont-Ferrand) ? Donne un chiffre précis, la source exacte (adresse web) et la date de publication.L'activité de fin de séance vous fait justement prendre l'IA en défaut sur une donnée vérifiable, et c'est ce réflexe que l'on cherche à installer.
Retenez la règle du cours : l'IA rédige, vous vérifiez ; un chiffre sans source n'est pas un chiffre.
Un secteur en constante évolution : RAG, mixture of experts, MCP, agents
| Depuis | Brique | Ce que c'est | À quoi ça sert |
|---|---|---|---|
| 2020 | RAG | Le modèle va chercher des documents avant de répondre | Répondre à partir de vos données, à jour, en citant la source |
| 2023 | Mixture of experts | Un modèle fait de sous-réseaux spécialisés, dont quelques-uns s'activent à chaque mot | Une qualité égale pour un coût de calcul bien moindre |
| 2024 | MCP | Une prise standard entre un modèle et un outil (base de données, agenda, site) | Faire agir l'IA dans vos logiciels sans connecteur sur mesure |
| 2025 | Agents | Un modèle dans une boucle : objectif, plan, outils, vérification | Confier une tâche entière, pas une question |
En quatre ans, la manière de construire les systèmes d'IA a changé quatre fois, et chaque étape répond à une faiblesse de la précédente.
Le RAG (retrieval-augmented generation, « génération à enrichissement contextuel », décrit en 2020 par Lewis et ses collègues chez Meta) consiste à aller chercher des documents pertinents, vos contrats, votre catalogue, avant de laisser le modèle rédiger.
Il sert à répondre à partir de vos données à vous, à jour, et à citer d'où vient la réponse, ce qui réduit les hallucinations.
Le mélange d'experts (mixture of experts) est une façon de construire le modèle lui-même : au lieu d'un seul bloc géant, on assemble des sous-réseaux spécialisés et seuls quelques-uns s'activent pour chaque mot.
Mixtral 8x7B, publié par Mistral le 11 décembre 2023, a popularisé l'idée et DeepSeek l'a poussée à l'extrême ; le résultat est un modèle moins coûteux à faire tourner pour une qualité égale.
Le MCP (Model Context Protocol), publié par Anthropic le 25 novembre 2024 puis adopté par OpenAI et Google en 2025, est une prise standard qui permet à un modèle de se brancher sur un outil : une base de données, un agenda, un site web, votre boutique.
Il sert à faire faire des choses à l'IA au lieu de seulement lui parler, sans réécrire un connecteur pour chaque outil.
L'agent, enfin, est un modèle placé dans une boucle : il reçoit un objectif, planifie, utilise ses outils, vérifie le résultat et recommence jusqu'à ce que ce soit fait.
Chacune de ces briques est arrivée en dix-huit mois environ, et la suivante est probablement déjà en préparation : ce que vous apprenez ici, c'est moins un outil qu'une capacité à suivre.
L'ordre importe pour décoder les offres commerciales : quand un éditeur vous vend « une IA connectée à vos données », c'est du RAG ; « une IA qui agit dans vos logiciels », c'est du MCP et des agents.
Sous le capot : des puces et de la géopolitique
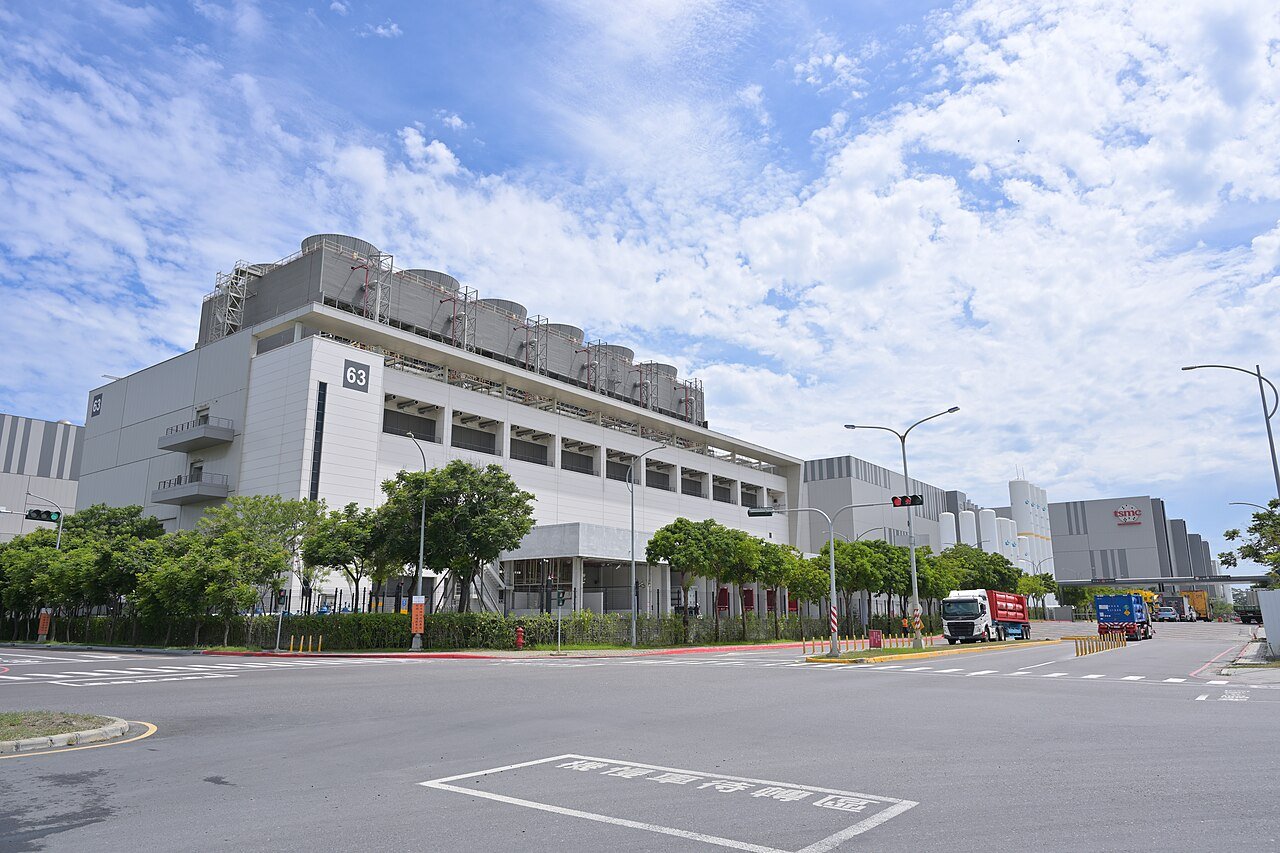
Nvidia conçoit ses puces mais ne les fabrique pas : elles sont gravées à Taïwan par TSMC, la première fonderie mondiale, qui assure plus des deux tiers de la production mondiale de puces sous-traitées (LeMagIT, juillet 2025).
Le AI Index 2026 le dit sans détour : presque toutes les puces d'IA de pointe sortent de cette seule entreprise, sur une île que la Chine considère comme une province à réunifier.
Une usine de puces de dernière génération coûte quinze milliards de dollars ou plus et prend des années à construire (IEEE Spectrum, février 2026, à propos des usines de mémoire) ; on ne déplace pas cette industrie en un mandat présidentiel.
Les États-Unis l'ont compris : depuis le 7 octobre 2022, ils interdisent l'exportation vers la Chine des puces d'IA les plus avancées et des machines qui servent à les fabriquer.
Les règles ont été durcies en octobre 2023, puis assouplies au cas par cas en 2025 et 2026, quand Washington a autorisé sous conditions la vente des puces H20 puis H200 à la Chine ; Pékin a répliqué en septembre 2025 en ordonnant à ses grandes entreprises de ne plus acheter de puces Nvidia (Wikipédia).
La Chine réagit en développant ses propres puces : DeepSeek V4, sorti en 2026, a été adopté par les fabricants chinois Huawei et Cambricon.
TSMC construit des usines en Arizona, dont la première a démarré en 2025, mais la dépendance à Taïwan restera la règle jusqu'à la fin de la décennie.
Pour un marketeur, cela veut dire qu'une IA « dans le cloud » repose sur une chaîne physique de quelques usines, et que son prix et sa disponibilité dépendent de décisions prises à Washington, Pékin et Taipei.
C'est aussi pourquoi les États parlent désormais de « souveraineté de l'IA », un thème que le AI Index 2026 place parmi ses dix constats de l'année.
L'actu : la crise de la mémoire
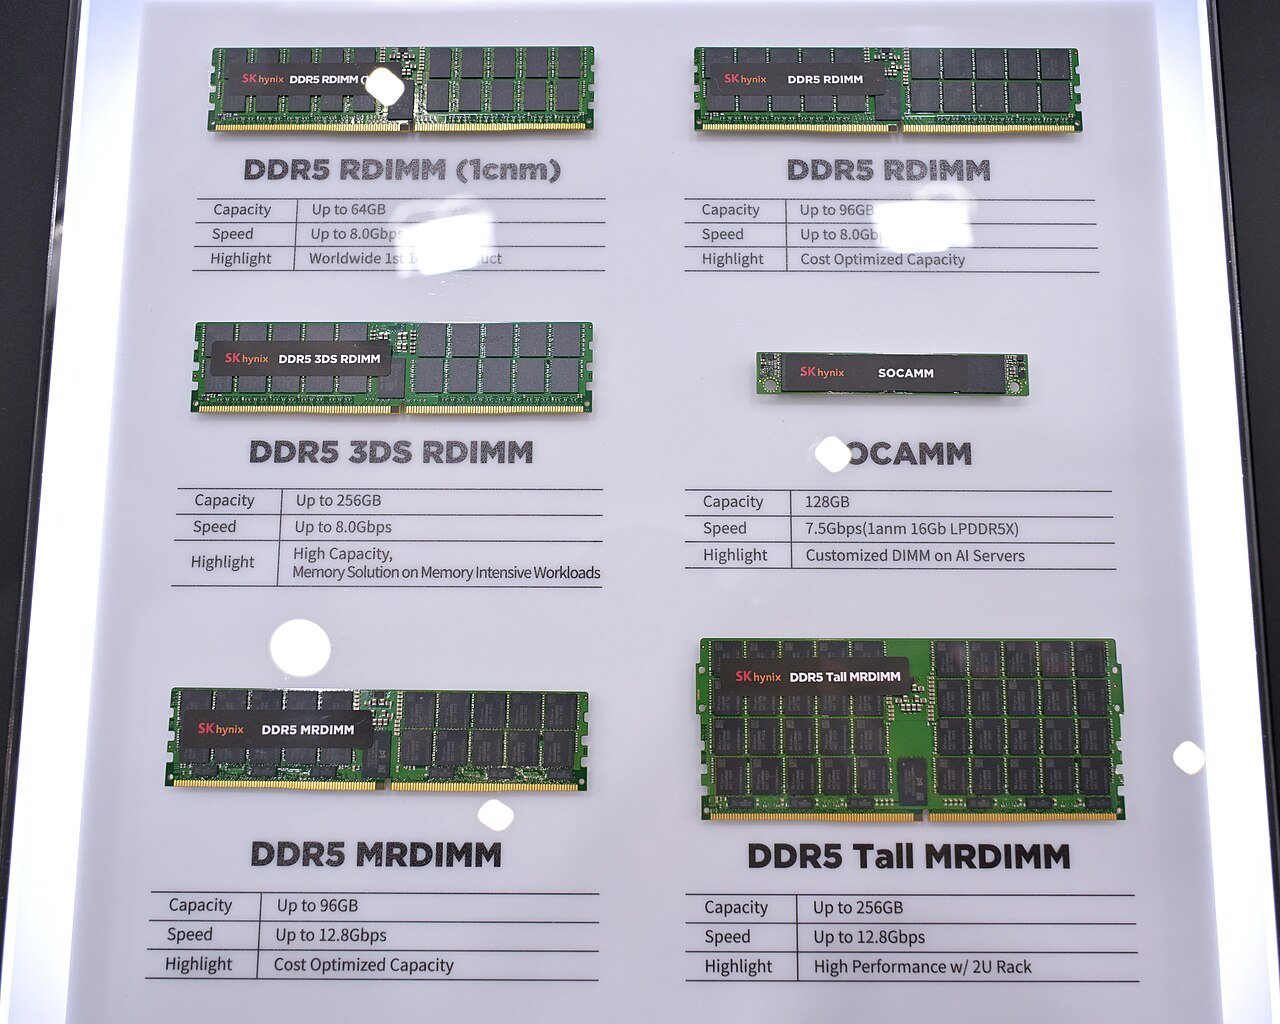
Depuis fin 2025, le monde manque de mémoire vive (RAM), et l'IA en est la cause directe.
Les puces d'IA ont besoin d'une mémoire spéciale, la HBM, environ trois fois plus chère et bien plus rentable pour les trois seuls fabricants mondiaux, Samsung, SK Hynix et Micron (IEEE Spectrum, février 2026).
Ces fabricants ont donc basculé leurs usines vers la HBM, et la mémoire ordinaire des PC et des téléphones s'est raréfiée.
Résultat : les prix de la DRAM avaient déjà augmenté de 172 % entre janvier et début novembre 2025 (Wikipédia), puis encore de 80 à 90 % au premier trimestre 2026 selon Counterpoint Research.
Le 3 décembre 2025, Micron a annoncé qu'il abandonnait la marque Crucial, ses barrettes et SSD grand public, pour réserver sa production aux centres de données ; les livraisons ont cessé en février 2026.
Les SSD suivent : les prix des puces NAND ont bondi de plus de 60 % en un mois en novembre 2025, et Western Digital avait vendu toute sa production de disques durs 2026 aux entreprises avant février.
Les fabricants d'ordinateurs répercutent : HP indiquait en février 2026 que la mémoire représentait 35 % du coût de fabrication d'un PC contre 15 à 18 % le trimestre précédent, et Apple a augmenté ses prix le 25 juin 2026.
Gartner et IDC attendent un recul du marché du PC de 10 à 11 % en 2026, et les dirigeants de Micron, Samsung et SK Hynix annoncent une pénurie jusqu'en 2027, 2028, voire 2030.
Le gagnant est le vendeur de mémoire : Micron, qui a quitté le grand public, vaut plus de 1 000 milliards de dollars le 14 septembre 2026, quatorzième capitalisation mondiale (CompaniesMarketCap).
C'est un cas d'école d'offre et de demande : une demande nouvelle et solvable, une offre rigide, des prix qui explosent et des marchés entiers, le PC d'entrée de gamme, qui cessent d'être rentables.
Ces chiffres datent de l'été 2026 ; la page Wikipédia citée est mise à jour en continu, allez y vérifier où en est la pénurie le jour où vous lisez ceci.
L'IA agentique, révolution de 2026 : la thèse du cours
Un chatbot répond à une question ; un agent reçoit un objectif et se débrouille pour l'atteindre.
Anthropic le définit ainsi dans Building effective agents (décembre 2024) : un système où le modèle dirige lui-même ses étapes et ses outils, au lieu de suivre un scénario écrit d'avance.
Concrètement, l'agent lit vos fichiers, ouvre un navigateur, lance des commandes, écrit du code, teste, corrige, puis vous rend compte.
Les premiers agents grand public datent de début 2025 : Operator d'OpenAI le 23 janvier, qui pilote un navigateur, et Claude Code en février, qui travaille dans un terminal.
La thèse de ce cours est que 2026 est l'année où ces agents cessent d'être des démonstrations pour devenir la manière normale de travailler avec l'IA.
Les données vont dans ce sens sans le prouver : le AI Index 2026 mesure que les agents sont passés de 12 % à 66 % de tâches réussies en un an sur OSWorld, un test de tâches réelles sur ordinateur, mais qu'ils échouent encore une fois sur trois.
Le même rapport note que le déploiement d'agents en entreprise reste inférieur à 10 % dans presque toutes les fonctions ; c'est précisément ce décalage entre capacité et usage qui fait une révolution en cours plutôt qu'accomplie.
Pour un marketeur, la différence est de nature : le chatbot vous aide à écrire un rapport, l'agent va chercher les données, construit le tableau de bord, le met en ligne et vous signale ce qui a changé.
Elle est aussi de risque : un agent qui agit peut se tromper en agissant, supprimer un fichier ou envoyer un e-mail, d'où les garde-fous, la vérification et les niveaux d'autorisation que vous verrez dans la partie « Je vous guide ».
La démonstration de la séance est un agent : un prompt, un fichier exporté, et un site complet qui fonctionne du premier coup.
Le vibe coding : coder sans savoir coder
Le 2 février 2025, Andrej Karpathy, cofondateur d'OpenAI et ancien directeur de l'IA de Tesla, décrit une nouvelle façon de programmer : on dit ce que l'on veut, on accepte le code proposé sans le lire, et on relance l'IA quand ça ne marche pas.
Il l'appelle vibe coding, coder « au feeling » ; le mot est entré dans le dictionnaire Merriam-Webster en mars 2025 et le Collins l'a élu mot de l'année 2025.
Pour un projet personnel, c'est une libération : un étudiant en gestion peut fabriquer en une heure un outil de suivi de budget, un site pour son association ou un tableau de bord, sans avoir appris à programmer.
Même Linus Torvalds, créateur de Linux, a reconnu en janvier 2026 avoir écrit ainsi un outil de visualisation pour un projet de loisir.
C'est exactement l'esprit de ce cours : la démonstration Claude Code plus loin dans cette séance est du vibe coding, et les projets de la partie « À vous de jouer » aussi.
En entreprise, la même pratique devient dangereuse, pour trois raisons.
La sécurité d'abord : en mai 2025, sur 1 645 applications créées avec l'outil Lovable, 170 laissaient n'importe qui lire les données personnelles des utilisateurs, et une étude Veracode d'octobre 2025 conclut que le code généré n'est pas devenu plus sûr en trois ans alors qu'il est devenu bien plus fonctionnel (Wikipédia).
La dette technique ensuite : personne ne comprend le code, donc personne ne sait le corriger ; une analyse de CodeRabbit en décembre 2025 trouve 1,7 fois plus de défauts majeurs dans le code coécrit par une IA.
La dépendance enfin : en juillet 2025, un agent de la plateforme Replit a effacé la base de données de production d'une entreprise malgré l'instruction explicite de ne rien modifier.
La règle du cours tient en une phrase : le vibe coding est parfait pour apprendre, tester et prototyper ; dès qu'il y a des clients, des données personnelles ou de l'argent, il faut quelqu'un qui lit le code.
Karpathy lui-même le disait dès le départ : c'est fait pour les projets du week-end que l'on peut jeter, pas pour un logiciel qui doit durer.
Qui paie ? Le coût réel de l'IA
| Qui paie | Combien | Source |
|---|---|---|
| Les investisseurs | 286 milliards de dollars d'investissement privé dans l'IA aux États-Unis en 2025 | AI Index 2026 |
| Les géants du cloud | Google : plus de 150 milliards de dollars d'équipements en 2025 | AI Index 2026 |
| OpenAI | 1 400 milliards de dollars d'engagements sur huit ans, pour 13 milliards de revenus | Wikipédia |
| Les abonnés | Environ 20 dollars par mois pour une formule standard | claude.com |
| Les utilisateurs gratuits | Leurs données et leur attention ; publicité dans ChatGPT depuis 2026 | Wikipédia |
Une IA « gratuite » coûte très cher à produire, et il faut savoir qui paie pour comprendre où va le marché.
L'entraînement d'un modèle de pointe mobilise des dizaines de milliers de GPU pendant des mois, et chaque réponse ensuite consomme du calcul dans un centre de données.
Les premiers payeurs sont les investisseurs : 286 milliards de dollars d'investissement privé dans l'IA aux États-Unis en 2025 selon le AI Index 2026, et un investissement mondial qui a plus que doublé en un an.
Les deuxièmes sont les géants du cloud, qui construisent les centres de données : Google seul a dépensé plus de 150 milliards de dollars d'équipements en 2025 (AI Index 2026).
OpenAI a pris des engagements de 1 400 milliards de dollars sur huit ans pour environ 13 milliards de revenus en 2025, financés par de la dette (Wikipédia) ; c'est ce déséquilibre qui nourrit le mot « bulle ».
Les abonnés payent ensuite : une formule standard coûte 20 dollars par mois chez Anthropic comme chez ses concurrents, et les entreprises payent à l'usage, au million de mots traités.
Les utilisateurs gratuits, c'est-à-dire vous, payent en données et en attention, exactement comme pour les réseaux sociaux du chapitre sur les traces ; le AI Index estime à 172 milliards de dollars par an la valeur que les consommateurs américains en retirent sans débourser.
La logique publicitaire a d'ailleurs rattrapé l'IA : OpenAI a introduit des annonces dans ChatGPT aux États-Unis en janvier 2026, puis en Europe le 24 août 2026 (Wikipédia).
La question ouverte de 2026 est celle de tout modèle économique : les revenus rattraperont-ils les dépenses avant que les investisseurs ne se lassent ?
Pour un marketeur, elle a une conséquence immédiate : les prix des outils d'IA ne sont pas stabilisés, et les gratuités d'aujourd'hui sont des périodes d'essai à l'échelle d'une industrie.
Les usages réels, mesurés
Entre les annonces et la réalité, il y a les statistiques publiques, et elles racontent une adoption rapide mais très inégale.
En 2025, 18 % des entreprises françaises de dix salariés ou plus utilisaient au moins une technologie d'IA, contre 10 % en 2024 ; la moyenne européenne est à 20 % et le Danemark à 42 % (Eurostat).
La taille compte plus que le pays : 17 % des petites entreprises européennes contre 55 % des grandes.
Le secteur aussi : 63 % dans l'information et la communication, 11 % dans la construction.
Et quand elles l'utilisent, c'est d'abord pour vendre : le marketing ou la vente est le premier usage de l'IA dans l'hébergement (59 % des entreprises utilisatrices) et le commerce de détail (48 %), selon la même enquête.
Côté grand public, le AI Index 2026 estime que l'IA générative a atteint 53 % d'adoption en trois ans, plus vite que l'ordinateur personnel ou Internet, mais avec de gros écarts selon le revenu par habitant.
Chez les étudiants américains, plus de quatre sur cinq déclarent utiliser l'IA générative pour leurs études, ce qui est probablement aussi votre cas.
Dans les organisations interrogées, 88 % disent utiliser l'IA quelque part, mais les agents restent en dessous de 10 % dans presque toutes les fonctions.
Ces chiffres disent une chose utile pour votre carrière : la majorité des entreprises françaises n'utilise pas encore l'IA, et celles qui recrutent cherchent des gens qui savent quoi en faire.
C'est la formule du premier chapitre : l'IA ne vous remplacera pas, mais quelqu'un qui la maîtrise, peut-être.
Les acteurs de l'IA
Le privé : sept entreprises, trois pays, des milliards
| Acteur | Siège | Créé en | Financé par | Produit que vous connaissez |
|---|---|---|---|---|
| OpenAI | San Francisco | 2015, comme association à but non lucratif | Microsoft (27 % du capital depuis octobre 2025), puis Amazon, Nvidia et SoftBank : 122 milliards de dollars levés en mars 2026 pour une valorisation de 852 milliards (CNBC) | ChatGPT |
| Anthropic | San Francisco | 2021, par d’anciens d’OpenAI | Amazon et Google (2023), Nvidia et Microsoft (novembre 2025) ; valorisée 965 milliards de dollars en mai 2026 | Claude, Claude Code |
| Google DeepMind | Londres et Mountain View | DeepMind en 2010, racheté par Google en 2014, fusionné avec Google Brain en 2023 | Alphabet, c’est-à-dire la publicité de Google (chiffre d’affaires du groupe en hausse de 24 % au deuxième trimestre 2026, Alphabet) | Gemini |
| Meta | Menlo Park | Laboratoire FAIR en 2013, Meta Superintelligence Labs en juin 2025 | Meta elle-même (publicité de Facebook et Instagram) ; 14,3 milliards de dollars mis dans Scale AI en juin 2025 | Meta AI (dans WhatsApp et Instagram), propulsé depuis juillet 2026 par le modèle Muse Spark ; modèles Llama à poids ouverts |
| Mistral AI | Paris | Avril 2023 | ASML (11 % du capital, septembre 2025), Samsung (3 milliards d’euros, septembre 2026) ; valorisée 21 milliards d’euros | Le Chat (renommé Vibe en mai 2026), modèles ouverts |
| xAI | San Francisco, supercalculateur à Memphis | Juillet 2023, par Elon Musk | Elon Musk et ses investisseurs ; fusion avec X (ex-Twitter) en mars 2025, absorbée par SpaceX en février 2026 | Grok |
| DeepSeek | Hangzhou (Chine) | 2023 | Le fonds spéculatif High-Flyer de son fondateur Liang Wenfeng, sans investisseur extérieur | DeepSeek (modèles publiés sous licence MIT) |
Les sept acteurs privés qui comptent en septembre 2026 — Sources : pages Wikipédia liées dans la première colonne, chiffres datés dans la colonne « Financé par ».
Derrière chaque assistant que vous utilisez, il y a une entreprise, un siège, et surtout un financeur.
Cinq des sept acteurs du tableau sont américains, un est chinois et un seul est européen, Mistral AI, installé à Paris.
Le premier enseignement du tableau, c’est l’ordre de grandeur de l’argent : OpenAI a levé 122 milliards de dollars en une seule fois en mars 2026, un record absolu pour une entreprise non cotée selon CNBC.
Le deuxième, c’est que les financeurs sont souvent les mêmes : Microsoft, Amazon, Google et Nvidia investissent dans OpenAI et dans Anthropic, puis leur vendent la puissance de calcul que cet argent sert à acheter.
Anthropic s’est ainsi engagée en novembre 2025 à acheter pour environ 30 milliards de dollars de capacités de calcul chez Microsoft, le jour même où Microsoft annonçait investir 5 milliards chez elle.
Google et Meta n’ont pas ce problème : leurs modèles sont payés par la publicité, qui reste le premier métier des deux groupes.
Meta a longtemps choisi une autre voie en publiant les poids de ses modèles Llama, ce que l’Open Source Initiative refuse d’appeler open source, la licence restreignant certains usages.
Depuis juillet 2026, le modèle qui fait tourner Meta AI, Muse Spark, n’est plus publié ; seul un petit modèle, Muse Glimmer, l’a été en août 2026.
DeepSeek est le cas à part : financé par un fonds spéculatif et non par la Silicon Valley, il a publié en janvier 2025 un modèle de raisonnement, R1, comparable à ceux d’OpenAI, ce qui a fait perdre 600 milliards de dollars de valeur boursière à Nvidia en une séance.
L’entreprise annonçait 5,57 millions de dollars pour un seul cycle d’entraînement de son modèle V3, un chiffre contesté car il exclut les salaires et le matériel : les 2 048 cartes Nvidia H800 utilisées valaient à elles seules environ 70 millions de dollars.
xAI illustre la fragilité de ces structures : neuf des onze cofondateurs qui entouraient Elon Musk étaient partis au printemps 2026, et la société a été absorbée par SpaceX le 2 février 2026 pour préparer une entrée en bourse.
Pour un futur gestionnaire, la question à se poser devant ces chiffres est simple : combien ces entreprises gagnent-elles, et quand ?
OpenAI prévoit 25 milliards de dollars de chiffre d’affaires en 2026 pour une valorisation de 852 milliards, soit 34 années de ventes, ce que certains analystes comparent à la bulle internet de 2000.
Le public et l’open source : de quatre outils à un seul
| Outil | C’est quoi | En 2023, il fallait… | En 2026 |
|---|---|---|---|
| Hugging Face | Le dépôt public des modèles (1,3 million de modèles hébergés en 2024) | Chercher le bon modèle, comprendre sa licence, télécharger des fichiers de plusieurs gigaoctets | Toujours la bibliothèque de référence, mais on n’y passe plus pour un usage courant |
| Transformers | La bibliothèque Python qui charge et fait tourner un modèle | Installer Python, PyTorch, les pilotes de carte graphique, puis écrire du code | Réservé à ceux qui développent ou entraînent des modèles |
| LangChain | Un cadre logiciel (octobre 2022) pour enchaîner les appels à un modèle | Coder chaque étape : lire un document, interroger le modèle, garder la mémoire de la conversation | Remplacé, pour l’usager, par les agents prêts à l’emploi |
| GitHub | L’hébergeur de code (100 millions d’inscrits en 2023, propriété de Microsoft) | Cloner des dépôts, suivre des instructions d’installation souvent périmées | Toujours là, mais l’agent s’en sert à votre place |
| Ollama | Un logiciel libre (juillet 2023) qui télécharge et fait tourner un modèle en une commande | Un outil parmi les autres, limité au dialogue dans le terminal | L’outil unique : il lance le modèle et le branche sur un agent |
La chaîne d’outils de l’IA ouverte, hier et aujourd’hui — Sources : sites officiels liés, chiffres Wikipédia (Hugging Face, GitHub, Ollama).
Face aux entreprises du tableau précédent, il existe un monde de modèles ouverts, que n’importe qui peut télécharger et faire tourner sur son ordinateur, sans compte ni abonnement.
Ces modèles viennent de Meta (Llama), de Mistral, de DeepSeek, d’Alibaba (Qwen), de Google (Gemma) ou de laboratoires publics, et ils sont déposés sur Hugging Face, une entreprise américaine fondée par trois Français, qui joue le rôle de bibliothèque.
Quand j’ai commencé à les utiliser en 2023, il fallait jongler avec quatre outils : Hugging Face pour trouver le modèle, Transformers pour le charger, LangChain pour enchaîner les étapes et GitHub pour récupérer le code des autres.
Chaque étape cassait pour une raison différente, une version de Python, un pilote de carte graphique, une bibliothèque renommée entre-temps.
En 2026, un seul outil suffit : Ollama, un logiciel libre qui télécharge un modèle et le fait tourner en une ligne.
terminalollama run gemma4
Le vrai changement, c’est qu’Ollama sait désormais brancher ce modèle sur un agent, c’est-à-dire un programme qui agit à votre place, avec la commande ollama launch claude, documentée par Ollama.
terminalollama launch claude
Cette commande ouvre Claude Code, l’agent d’Anthropic, mais en le faisant tourner sur le modèle ouvert de votre choix, sur votre machine, où restent vos données.
La même documentation propose ollama launch opencode, qui lance OpenCode, un agent entièrement open source, et la liste complète comprend aussi Codex (OpenAI), Droid (Factory) et VS Code.
Deux autres agents méritent d’être connus : Gemini CLI, que Google publie en open source avec un usage gratuit sur simple compte Google, et Codex CLI, l’équivalent chez OpenAI.
Ollama précise qu’un agent a besoin d’un modèle avec une mémoire de travail d’au moins 64 000 jetons, ce qui demande un ordinateur récent, et propose sinon des modèles hébergés dans son cloud.
Nous ferons l’installation ensemble dans le chapitre suivant ; retenez ici que la barrière technique de 2023 a disparu.
Le modèle ne suffit pas : ce qui compte, c’est l’écosystème autour
Un modèle seul, c’est une boîte qui reçoit du texte et renvoie du texte : il ne voit ni vos fichiers, ni le web, ni la date du jour.
Ce qui fait la valeur d’une IA en 2026, c’est tout ce qui entoure cette boîte, et c’est ce que le schéma appelle l’agent.
La première capacité qui compte est de raisonner, c’est-à-dire de découper une tâche en étapes avant de répondre, ce que les modèles font depuis fin 2024 en écrivant leur brouillon avant la réponse.
La deuxième est de ne pas halluciner, et le chapitre sur l’enjeu du moment vous a montré que le modèle seul en est incapable ; l’agent, lui, peut aller vérifier.
Demandez à un chatbot le chiffre d’affaires 2025 de Michelin : il vous donnera un nombre plausible ; demandez-le à un agent, il ouvrira le rapport annuel sur le site de Michelin et vous citera la page.
La troisième est de garder le cap sur l’objectif du prompt pendant des dizaines d’étapes sans se perdre, ce qui distingue un bon agent d’un mauvais bien plus que le modèle qu’il utilise.
Viennent ensuite les outils : faire des requêtes internet, ouvrir un site précis, lire et écrire des fichiers sur votre disque, lancer une commande dans le terminal.
Le standard qui permet de brancher d’autres outils, votre agenda, vos mails ou une base de données, s’appelle MCP, vu au chapitre sur l’enjeu du moment.
C’est pour cela que je vous recommande Claude Code même avec un modèle open source : la boucle de travail, la gestion des fichiers, la vérification des résultats sont dans l’agent, pas dans le modèle.
Le même modèle Qwen lancé dans le terminal d’Ollama et lancé dans Claude Code ne donne pas la même chose : dans le premier cas il discute, dans le second il construit un site.
Claude Code n’est pas open source, mais il est gratuit à installer et s’adapte au modèle qu’on lui donne ; OpenCode fait la même chose en logiciel libre, avec un peu moins de finition.
Pour un marketeur, la conclusion est pratique : ne choisissez pas une IA sur le nom de son modèle, choisissez-la sur ce qu’elle sait faire dans votre environnement de travail.
Les plus performants restent privés : benchmarks crédibles ou foutaises ?
Un benchmark est un examen standardisé que l’on fait passer aux modèles pour les comparer, et chaque éditeur publie ses scores le jour de la sortie d’un modèle.
Le plus ancien, MMLU (2020), est un QCM de 15 908 questions dans 57 matières ; les experts humains y font environ 89,8 %, et les meilleurs modèles atteignent 88 % depuis mi-2024, ce qui l’a rendu inutile pour les départager.
Une analyse de juin 2024 a d’ailleurs trouvé des erreurs dans 6,5 % de ses questions, jusqu’à 57 % en virologie : on mesurait aussi la capacité à reproduire des corrigés faux.
SWE-bench Verified est plus sérieux : 500 bugs réels tirés de dépôts GitHub, que le modèle doit corriger en modifiant le code jusqu’à ce que les tests passent.
Le graphique montre le score des modèles Claude passer de 33 % à 81 % en vingt mois, mais lisez la légende : ces chiffres sont déclarés par Anthropic, sur son propre montage, avec ses propres réglages.
Arena, né à Berkeley en avril 2023 sous le nom de Chatbot Arena puis appelé LMArena jusqu’en janvier 2026, évite ce biais en faisant voter le public entre deux réponses anonymes, ce qui produit un classement du type Elo des échecs.
Mais une étude de 2025, The Leaderboard Illusion, a mesuré que Meta avait testé 27 variantes privées avant de publier Llama 4, ne gardant que la mieux classée.
La même étude chiffre que Google et OpenAI ont reçu respectivement 19,2 % et 20,4 % des données de l’arène, contre 29,7 % pour 83 modèles ouverts réunis, un accès qui peut améliorer le score jusqu’à 112 %.
Reste le problème de fond, la contamination : les questions des examens circulent sur internet, donc dans les données d’entraînement, et le modèle a parfois déjà vu le sujet.
Des chercheurs ont écrit des problèmes d’arithmétique inédits, GSM1k, et ont mesuré des baisses allant jusqu’à 8 points chez certaines familles de modèles qui avaient appris l’examen par cœur.
Ni crédibles ni foutaises, donc : les benchmarks disent la tendance, et la tendance est nette, mais la décimale qui sépare deux modèles ne veut rien dire.
Au 14 septembre 2026, les dix premières places du classement texte d’Arena sont toutes occupées par des modèles privés, sept versions de Claude, deux de Muse Spark (Meta) et une de Gemini ; dans le classement dédié au code web, GPT-6 est premier et les chinois Qwen et Kimi entrent dans les cinq premiers.
Le seul benchmark qui vaut pour vous est votre tâche : le même prompt, collé dans deux ou trois assistants, et vous jugez.
Pourquoi ces écarts ?
La première réponse est la distribution, une notion que nous retrouverons à la séance sur le mix marketing : le meilleur produit ne gagne pas, celui qui est déjà là où vous êtes gagne.
Android équipe 67,6 % des téléphones du monde en août 2026, et Gemini y est préinstallé, dans Chrome, dans Gmail et dans les résultats de recherche Google.
Apple équipe les 32 % restants, et c’est pourquoi l’accord Siri-Gemini de janvier 2026 vaut plus pour Google que n’importe quelle campagne de publicité.
Meta AI est l’exemple le plus frappant : un milliard d’utilisateurs mensuels annoncés en mai 2025, sans que personne n’ait choisi d’y aller, parce que l’assistant est dans la barre de recherche de WhatsApp et d’Instagram.
Copilot est dans chaque Windows et chaque Office, et pourtant sa part de visites web reste autour de 1,5 % : la distribution donne l’accès, elle ne garantit pas l’usage.
La deuxième réponse est la gratuité : tous ces assistants ont une version gratuite, et sur les 900 millions d’utilisateurs hebdomadaires de ChatGPT, 50 millions seulement paient un abonnement, soit un peu plus de 5 %.
Un modèle économique où près de 95 % des clients ne paient pas explique les levées de fonds du premier titre, et pose la question du jour où il faudra rentabiliser.
La troisième réponse est l’intégration aux outils existants : Gemini écrit dans Google Docs, Copilot dans Word, Claude dans le terminal et dans les logiciels des développeurs.
Chacun s’installe dans les outils que ses clients ouvrent déjà, ce qui explique que les courbes ne se ressemblent pas selon qu’on mesure des visites web, des utilisateurs d’application ou des revenus.
Claude, avec 8,2 % des visites web, réalisait déjà un milliard de dollars de chiffre d’affaires annualisé avec le seul Claude Code en décembre 2025 : son public est plus étroit, mais il paie.
ChatGPT, lui, a bénéficié d’un avantage que le marketing appelle la prime au premier entrant : en novembre 2022, il était seul, et le nom est devenu le nom commun de la catégorie, comme Frigidaire ou Kleenex.
Sa part recule non parce qu’il est devenu mauvais, mais parce que les concurrents ont rattrapé le modèle et qu’ils disposent de canaux de distribution qu’OpenAI n’a pas.
D’où le rachat par OpenAI, en mai 2025 et pour 6,5 milliards de dollars, de la société de Jony Ive, l’ancien designer de l’iPhone : sans téléphone ni système d’exploitation, il lui faut inventer son propre canal.
Je vous guide
Trois façons d'avoir un agent : votre machine, une machine louée, un service privé
Avant d'installer quoi que ce soit, il y a un choix à faire, et il dépend de votre ordinateur et de votre budget.
Premier choix, votre propre machine avec un modèle gratuit : Ollama télécharge un modèle ouvert, gpt-oss ou gemma, et le fait tourner chez vous ; il faut un Mac à puce Apple avec assez de mémoire, ou un PC avec une vraie carte graphique, sinon c'est trop lent pour travailler.
Deuxième choix, une machine louée avec le même modèle gratuit : un serveur virtuel, comme le KVM 2 de Hostinger, allumé en permanence ; sans carte graphique, un modèle y répond lentement, mais la machine est à vous, accessible de partout, et c'est aussi là qu'on héberge un site.
Troisième choix, un service privé : Claude Code ou Codex, par abonnement ; les modèles les plus capables, sans rien installer de lourd, en échange de vingt dollars par mois et de vos données qui partent chez l'éditeur.
| 1. Votre machine, modèle gratuit | 2. Machine louée, modèle gratuit | 3. Service privé | |
|---|---|---|---|
| Ce qu'il faut | un Mac à puce M avec 16 Go de mémoire au moins, ou un PC avec une carte graphique de 8 Go et plus | un serveur virtuel loué, par exemple Hostinger KVM 2 (2 vCPU, 8 Go, 100 Go), et savoir s'y connecter | un compte et un abonnement, Claude Pro à 20 $ par mois, Claude Code compris |
| Performance | correcte avec un modèle de 20 milliards de paramètres sur une bonne machine ; en dessous, des réponses plus faibles | faible : sans carte graphique, un petit modèle répond lentement ; c'est surtout un ordinateur toujours allumé, pour un site ou un script | la meilleure : les modèles les plus capables, qui raisonnent longtemps, lisent de gros fichiers, corrigent seuls |
| Coût | 0 € si vous avez la machine ; sinon, c'est le prix de la machine | 7,99 € par mois la première période, 14,99 € ensuite | 20 $ par mois, plus si vous en faites beaucoup |
| Vie privée | rien ne sort de votre ordinateur : les données de la boutique restent chez vous | vos données sont sur une machine louée, chez un hébergeur, sous votre contrôle | vos prompts et vos fichiers partent chez l'éditeur, sous ses conditions d'utilisation |
| Pour qui | ceux qui ont la machine et veulent apprendre sans rien payer | un cas particulier, quand il faut que ça tourne sans votre ordinateur | ceux qui veulent le meilleur résultat, tout de suite |
Modèle ouvert ou modèle privé : un modèle ouvert est publié avec ses poids, le fichier qui contient tout ce qu'il a appris, et n'importe qui peut le télécharger et l'exécuter ; un modèle privé, Claude ou GPT, n'est accessible qu'à travers le service de son éditeur.
Les modèles ouverts les plus utilisés en 2026 viennent de Google, de Meta, de Mistral, d'OpenAI avec gpt-oss, et de laboratoires chinois comme Qwen ou DeepSeek, tous dans la bibliothèque d'Ollama.
Le modèle ne fait pas tout : il faut un outil qui le fasse travailler sur vos fichiers, et la commande ollama launch claude lance Claude Code lui-même, branché sur un modèle ouvert qui tourne chez vous (documentation d'Ollama) ; OpenCode, entièrement ouvert, accepte n'importe quel modèle.
| Outil | Modèle | Où il tourne | Prix (septembre 2026) | Site officiel |
|---|---|---|---|---|
| Claude et Claude Code | privé (Anthropic) | cloud | gratuit avec limites ; Pro 20 $ par mois, Claude Code inclus | claude.com |
| ChatGPT | privé (OpenAI) | cloud | gratuit avec limites ; formules payantes | chatgpt.com |
Ollama, puis ollama launch claude | ouvert (gpt-oss, gemma3, qwen3, etc.) | votre ordinateur | gratuit ; 16 Go de mémoire conseillés | ollama.com |
| OpenCode | au choix, ouvert ou privé | votre ordinateur ou le cloud | gratuit (le modèle en ligne peut être payant) | opencode.ai |
Pour ce module, les trois conviennent : ce qui compte, c'est d'avoir en fin d'après-midi un agent qui lit vos fichiers et exécute du code ; on installera celui qui correspond à votre machine, et on verra les autres en démonstration.
Les données de Lumineva sont personnelles : si vous choisissez un service privé, ne lui envoyez que ce qui est nécessaire, et jamais le fichier clients entier.
L'IA agentique : démonstration
Démonstration en direct, avec les données de Lumineva : ce que fait un agent quand on lui donne un dossier de fichiers et une question.
Parler à un agent : contexte, résultat attendu, vérification
| Principe | Ce qu'on oublie la première fois | Ce qu'on écrit |
|---|---|---|
| 1. Le contexte | ce qu'il y a dans le dossier, d'où ça vient, à quoi servira le résultat | « Ce dossier contient les exports Shopify d'une boutique ; une ligne d'orders.csv est une ligne produit, pas une commande. » |
| 2. Le résultat attendu | la forme, le périmètre, le critère de réussite | « Un tableau des commandes par mois, commandes payées seulement, dédupliquées sur order_key. » |
| 3. La vérification | que l'agent doit prouver ce qu'il avance | « Affiche le nombre de lignes lues, le nombre de commandes distinctes, et un exemple de commande avec ses lignes. » |
| 4. L'itération | que le premier essai est rarement le bon | « Le total ne colle pas avec Shopify : les remboursements sont-ils comptés ? Corrige et dis ce que tu as changé. » |
Un agent fait ce qu'on lui demande, pas ce qu'on pense : la qualité de la consigne fait l'essentiel du résultat, et sur des données, la consigne doit contenir ce qu'un collègue aurait besoin de savoir avant de commencer.
Le contexte, d'abord : ce que contient le dossier, d'où viennent les fichiers, ce qu'est une ligne ; un agent qui ignore qu'une ligne d'orders.csv est une ligne produit comptera trois commandes là où il y en a une.
Le résultat attendu, ensuite : la forme, un tableau, un graphique, un fichier ; le périmètre, quelles commandes, quelle période ; et le critère qui dira que c'est réussi.
La vérification, c'est ce qui distingue une réponse d'un résultat : demandez à l'agent d'afficher ce qu'il a lu et ce qu'il a compté, et vérifiez un chiffre que vous connaissez par ailleurs, le total d'un mois dans Shopify par exemple.
L'itération, enfin : le premier essai est rarement le bon, et c'est normal ; on lit, on dit ce qui ne va pas, on relance, en demandant à chaque fois ce qui a changé.
Un exemple sans données de boutique, pour commencer : voici la consigne que tout le monde écrit la première fois.
promptFais-moi un lecteur de musique.
L'agent choisira à votre place le langage, le format et les fonctions, et vous rendra quelque chose qui n'est pas ce que vous vouliez, sans que ce soit sa faute.
Le même besoin, avec les quatre principes.
promptDans ce dossier se trouve Liked_Songs.csv, l'export de ma playlist Spotify (une ligne par titre). Construis un site web local qui liste mes titres avec une recherche par artiste et un tri par date d'ajout. Contraintes : un seul dossier, aucune installation, le site doit s'ouvrir en double-cliquant sur index.html. Quand tu as fini, affiche le nombre de lignes du CSV et le nombre de titres affichés, vérifie qu'ils sont égaux, et dis-moi ce que tu as vérifié.
Le second est plus long, mais chaque phrase enlève une décision à l'agent et une mauvaise surprise à vous ; le même gabarit servira pour orders.csv, en remplaçant la playlist par la boutique.
Gardez vos consignes qui ont marché dans un fichier texte à la racine de votre projet : c'est ce fichier, plus que le code, que vous réutiliserez.
Installer les outils en cinq minutes
| Ce que vous voulez | Ce qu'il faut | La commande | Mode d'emploi officiel |
|---|---|---|---|
| La démo telle quelle (Claude Code) | un compte Claude Pro, un terminal | curl -fsSL https://claude.ai/install.sh | bash (Mac) ; irm https://claude.ai/install.ps1 | iex (Windows) | code.claude.com |
| La même chose, gratuite et locale | Ollama installé, 16 Go de mémoire conseillés | ollama launch claude | docs.ollama.com |
| Un agent entièrement ouvert | un terminal, puis un modèle au choix | curl -fsSL https://opencode.ai/install | bash | opencode.ai |
| Votre playlist en CSV | un compte Spotify | bouton Export sur le site | exportify.net |
Avant la démo, voici ce qu'il faut installer, une seule fois, sur un Mac ou un PC ; comptez cinq minutes et une connexion correcte.
Option payante, celle de la démo : créez un compte sur claude.com, prenez la formule Pro, qui est la première à inclure Claude Code, puis installez l'outil en collant dans le Terminal la commande donnée sur la page d'installation.
terminalcurl -fsSL https://claude.ai/install.sh | bash
Sur Windows, la même chose se fait dans PowerShell.
terminalirm https://claude.ai/install.ps1 | iex
Option gratuite : téléchargez Ollama, lancez-le, puis tapez la commande qui démarre Claude Code branché sur un modèle ouvert ; si elle vous signale que Claude Code manque, installez-le d'abord avec la commande ci-dessus, ce qui ne demande aucun abonnement.
terminalollama launch claude
Ollama vous propose alors un modèle ; sur un portable avec 8 Go de mémoire, prenez un petit modèle comme gemma3 4B, et avec 16 Go ou plus, gpt-oss 20B ou qwen3 donnent des résultats nettement meilleurs.
Attention, Ollama propose aussi des modèles dits « cloud », qui tournent sur ses propres serveurs : ils sont plus puissants, mais vos données quittent alors la machine, comme avec Claude.
Troisième voie, tout aussi gratuite, OpenCode s'installe d'une commande et se configure ensuite avec le modèle de votre choix, local ou en ligne.
terminalcurl -fsSL https://opencode.ai/install | bash
Dans tous les cas, la première utilisation demande de se connecter ou de choisir un modèle, et l'outil vous guide.
Enfin, préparez votre export Spotify sur Exportify : cliquez sur « Get Started », connectez-vous avec votre compte Spotify, autorisez la lecture seule de vos playlists, et cliquez sur « Export » en face de la playlist choisie, ou de vos titres likés, pour récupérer un fichier CSV.
Si vous n'avez pas Spotify, n'importe quel tableau de titres (artiste, titre, album, durée) exporté depuis Deezer ou Apple Music, ou tapé à la main dans un tableur, fera l'affaire, du moment qu'il est enregistré en CSV.
Le projet démo, version facile : reconstruire Mélodie
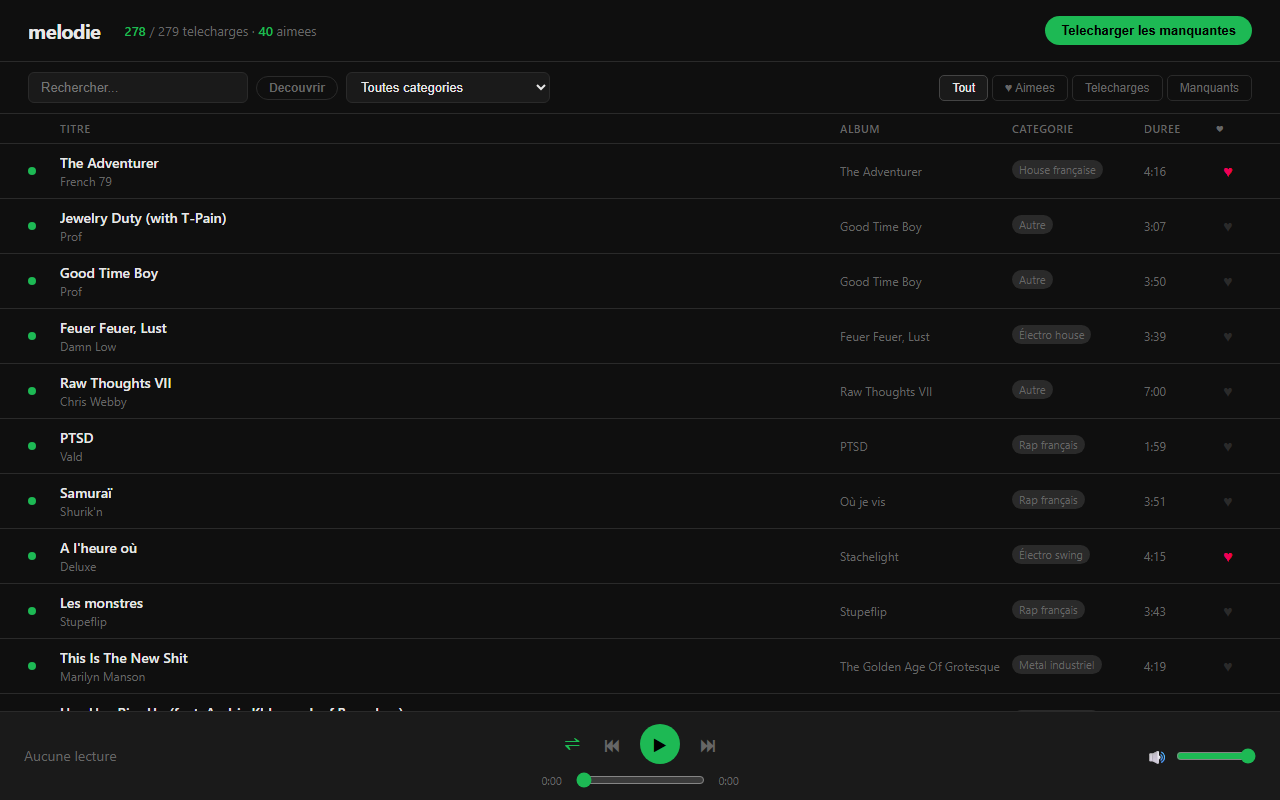
Mélodie est le lecteur de musique que j'utilise chez moi, construit avec Claude Code à partir d'un seul fichier, l'export CSV de mes titres aimés sur Spotify.
Il tourne sur mon PC Windows sans abonnement à un service de streaming : un petit serveur Python, une base de données locale, un dossier de 280 fichiers audio, une page web qui liste 279 titres avec recherche, filtre par catégorie, onglet des titres aimés et lecture aléatoire, et un fichier melodie.exe à double-cliquer qui lance tout et ouvre le navigateur.
Le CSV vient d'Exportify et contient, pour chaque titre, 24 colonnes : identifiant Spotify, titre, album, artistes, date de sortie, durée en millisecondes, genres, label, et même des mesures comme la dansabilité ou le tempo.
| Track URI | Track Name | Artist Name(s) | Album Name | Duration (ms) | Genres |
|---|---|---|---|---|---|
| spotify:track:7ye7Qoj5… | The Adventurer | French 79 | The Adventurer | 256000 | house française |
| spotify:track:6OXc6JDb… | Jewelry Duty (with T-Pain) | Prof;T-Pain | Good Time Boy | 187129 | |
| spotify:track:49u9ZoIJ… | Feuer Feuer, Lust | Damn Low;NOYSE | Feuer Feuer, Lust | 219000 | électro house, hypertechno, hard techno |
La version facile que nous allons reconstruire garde l'essentiel, la bibliothèque, la recherche, les favoris et l'écoute, et laisse de côté le téléchargement audio, la découverte et la radio, que je montrerai ensuite comme des modifications demandées en une phrase.
Je la construis en direct sur mon Mac, alors que Mélodie vit sous Windows, avec Claude Code et le modèle Opus, le plus puissant de la gamme Claude, que mon abonnement me permet d'utiliser ; vous pourrez refaire la même chose avec ollama launch claude et juger si le résultat tient la comparaison.
Étape 1 : exportez votre playlist depuis Exportify et enregistrez le fichier CSV dans un nouveau dossier vide, par exemple musique, sur le Bureau.
Étape 2 : ouvrez un terminal dans ce dossier ; sur Mac, un clic droit sur le dossier puis « Nouveau terminal au dossier », sur Windows, un clic droit dans le dossier puis « Ouvrir dans le Terminal ».
Étape 3 : lancez l'agent, claude avec un abonnement ou ollama launch claude avec un modèle local, et attendez l'invite.
Étape 4 : copiez le prompt ci-dessous, tel quel, collez-le dans l'agent et validez ; il est le même pour toute la promotion, pour que nous comparions des résultats comparables.
promptJe suis dans un dossier qui contient un seul fichier, Liked_Songs.csv : l'export d'une playlist Spotify réalisé avec Exportify (colonnes Track URI, Track Name, Album Name, Artist Name(s), Release Date, Duration (ms), Added At, Genres, entre autres ; les artistes sont séparés par des points-virgules).

Construis dans ce dossier un site web local et statique qui me sert de bibliothèque musicale, dans l'esprit de Spotify mais épuré. Contraintes :

1. Aucun serveur, aucune installation, aucune dépendance : le site doit fonctionner en double-cliquant sur index.html. Comme un navigateur refuse de lire un CSV depuis un fichier local, écris un petit script Python convertir.py qui transforme le CSV en donnees.js (une variable JavaScript contenant la liste des titres), exécute-le toi-même, et ne recopie jamais les données à la main.

2. Fichiers attendus, et rien d'autre : index.html, style.css, app.js, donnees.js, convertir.py, Lancer.command (Mac, rendu exécutable) et Lancer.bat (Windows), qui ouvrent index.html dans le navigateur par défaut, et un README.md de dix lignes qui explique comment relancer la conversion si le CSV change.

3. Fonctions, par ordre de priorité : la liste de tous les titres (titre, artiste principal, album, durée au format m:ss, genre principal) ; une recherche instantanée sur titre, artiste et album ; un filtre par genre ; un tri par date d'ajout, le plus récent en premier par défaut ; un bouton cœur qui marque un titre comme aimé, avec un onglet « Aimés », mémorisé dans le navigateur (localStorage) ; en haut de page, le nombre de titres et la durée totale de la bibliothèque.

4. Pour l'écoute : un clic sur un titre affiche, dans un panneau en bas de page, le lecteur intégré de Spotify du morceau (https://open.spotify.com/embed/track/ID, où ID est la fin du Track URI). Pas de téléchargement de musique.

5. Interface sobre, fond sombre, lisible sur un écran de portable, en français, sans framework ni bibliothèque externe ni CDN, avec un code commenté brièvement.

6. Avant de me rendre la main : exécute convertir.py, vérifie que donnees.js contient exactement autant de titres que le CSV a de lignes, que index.html référence bien style.css, donnees.js et app.js, et que les fichiers de lancement ouvrent index.html. Si quelque chose échoue, corrige et reteste. Ça doit marcher du premier coup quand je double-clique.
Étape 5 : pendant deux à cinq minutes, l'agent lit le CSV, écrit les fichiers, exécute la conversion et vous demande parfois une permission ; répondez oui aux actions dans le dossier, et lisez ce qu'il raconte.
Étape 6 : quand il rend la main, ouvrez le dossier et double-cliquez sur Lancer.command (ou Lancer.bat) : le site s'ouvre dans votre navigateur avec votre bibliothèque, et il doit marcher du premier coup.
Étape 7 : si ce n'est pas le cas, ne cherchez pas la panne vous-même, décrivez-la à l'agent en collant le message d'erreur, et laissez-le corriger ; c'est le troisième principe du prompting en action.
Étape 8 : demandez ensuite une modification en une phrase, un tri par artiste, un thème clair, une colonne avec l'année, et regardez le temps qu'il lui faut ; c'est là que vous comprendrez ce que ça change pour un marketeur qui a besoin d'un outil ce soir et pas dans trois mois.